
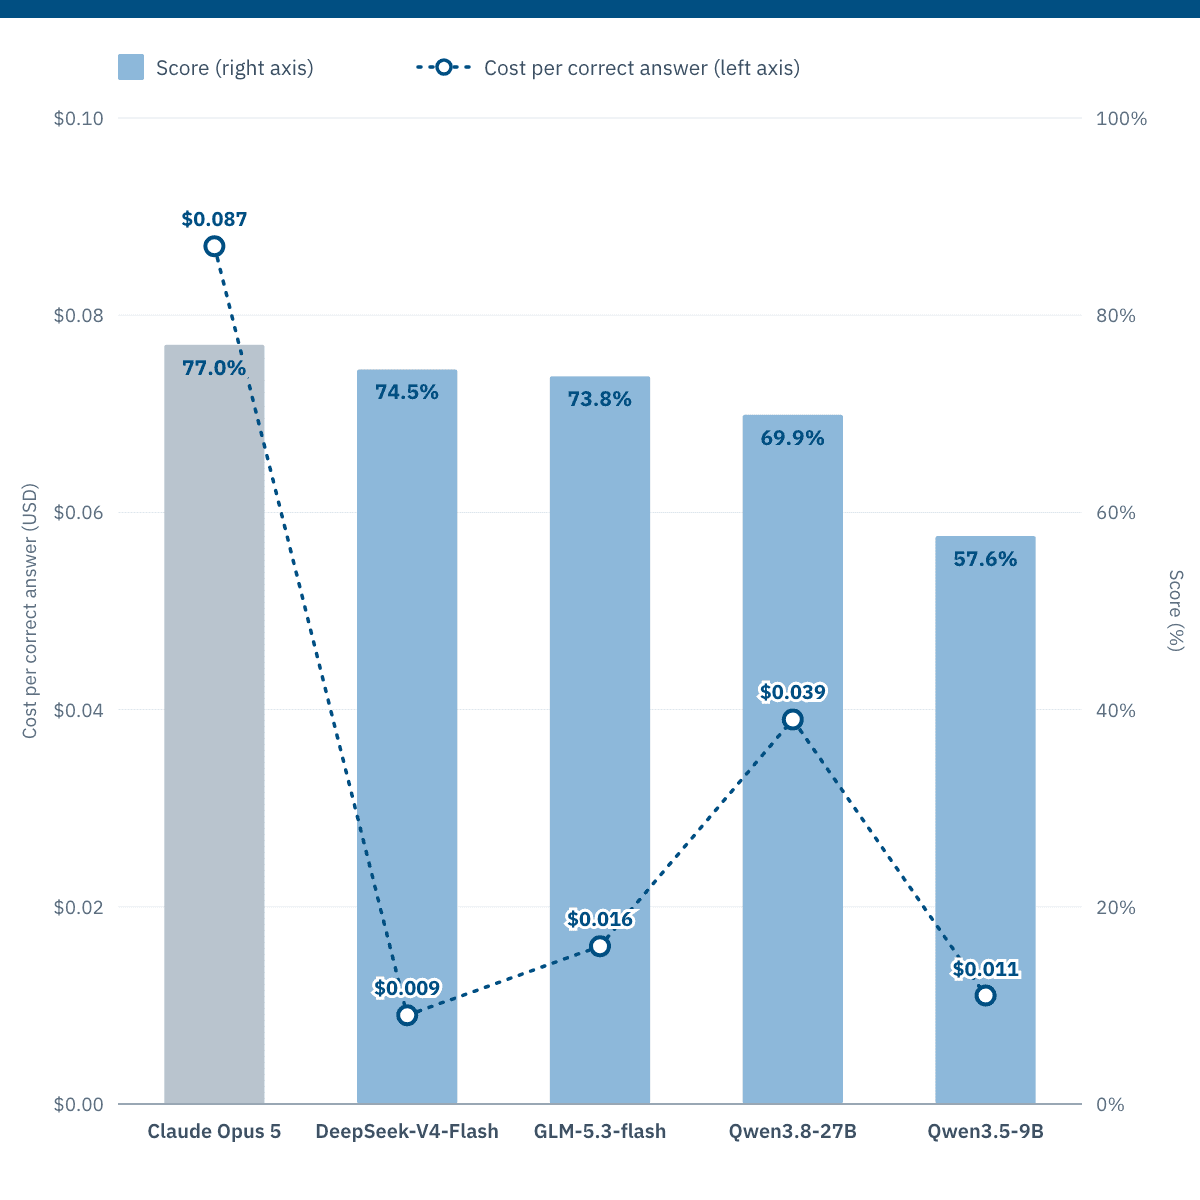
- DeepSeek-V4-Flash (74,5 %) und GLM-5.3-flash (73,8 %) liegen statistisch gleichauf mit Claude Opus 5 (77,0 %).
- Eine richtige Antwort kostete mit DeepSeek-V4-Flash 0,009 $ und mit GLM-5.3-flash 0,016 $, mit Opus 5 dagegen 0,087 $.
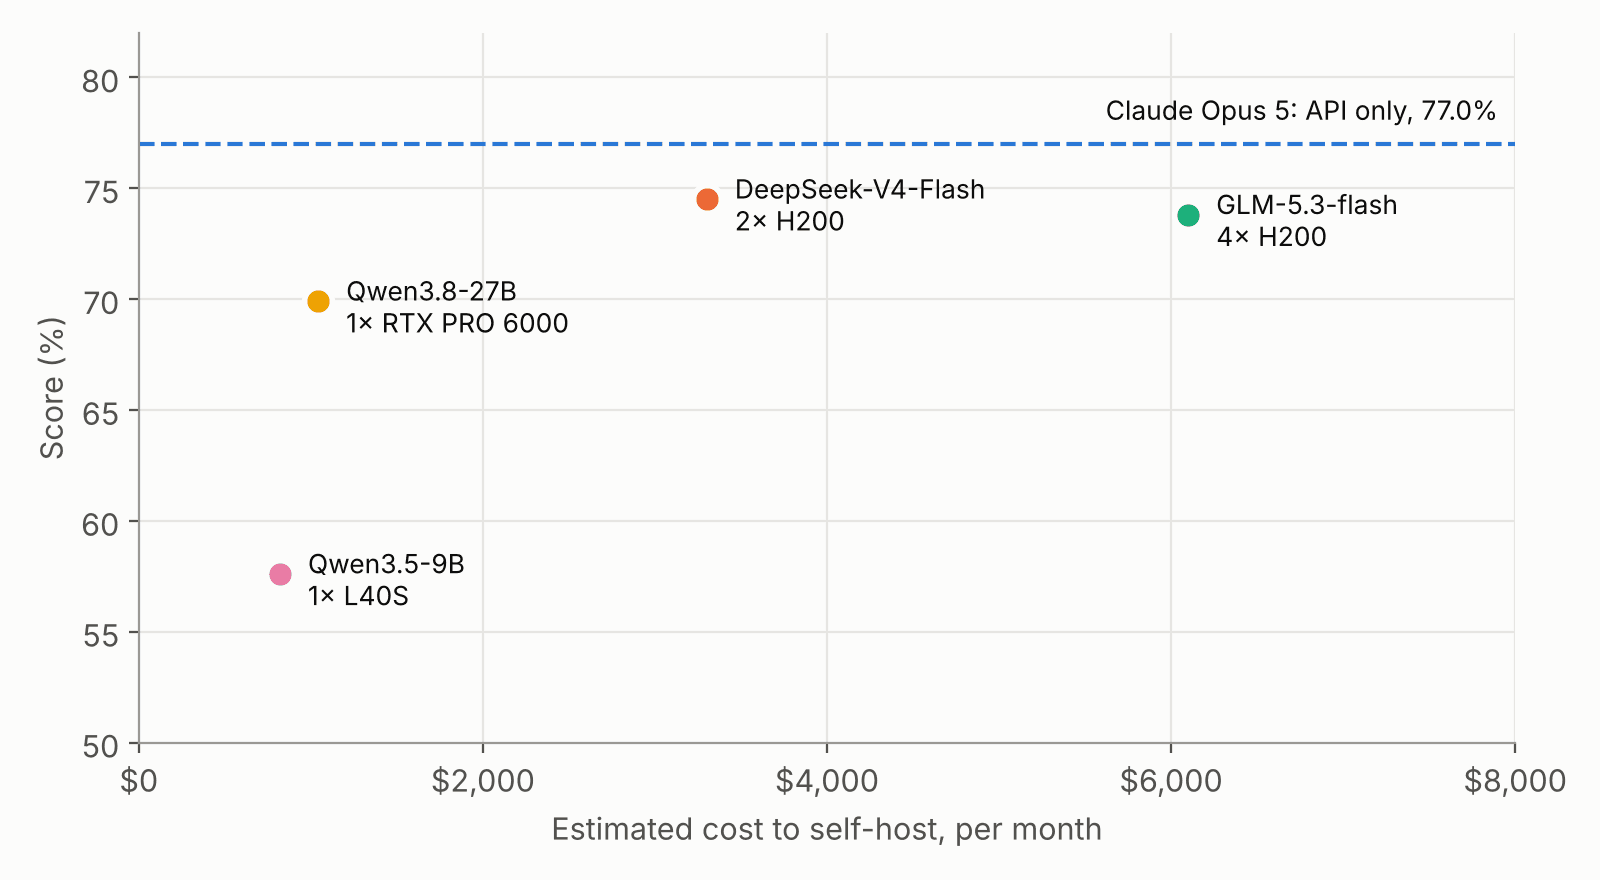
- Die beiden offenen Modelle, die mithielten, lassen sich kosteneffizient per API nutzen; wer sie selbst betreiben will, braucht zwei bis vier Rechenzentrums-GPUs. Qwen3.8-27B läuft auf einem starken Laptop, blieb im Score aber zurück.
1. Welche Schritte kann ein günstigeres Modell übernehmen?
Eine Datenanalyse besteht aus Schritten sehr unterschiedlicher Schwierigkeit. Manche sind offen: Welche Frage stellt man, welche Methode passt dazu, welche Entscheidung soll das Ergebnis am Ende stützen? Andere sind Routine der Datenaufbereitung: erkennen, was in einer Spalte steht, die Spalten finden, über die sich zwei Tabellen verknüpfen lassen, oder eine Tabelle von JSON nach CSV umwandeln. Ein Frontier-Modell beherrscht beide Arten von Schritten — zu Frontier-Preisen.
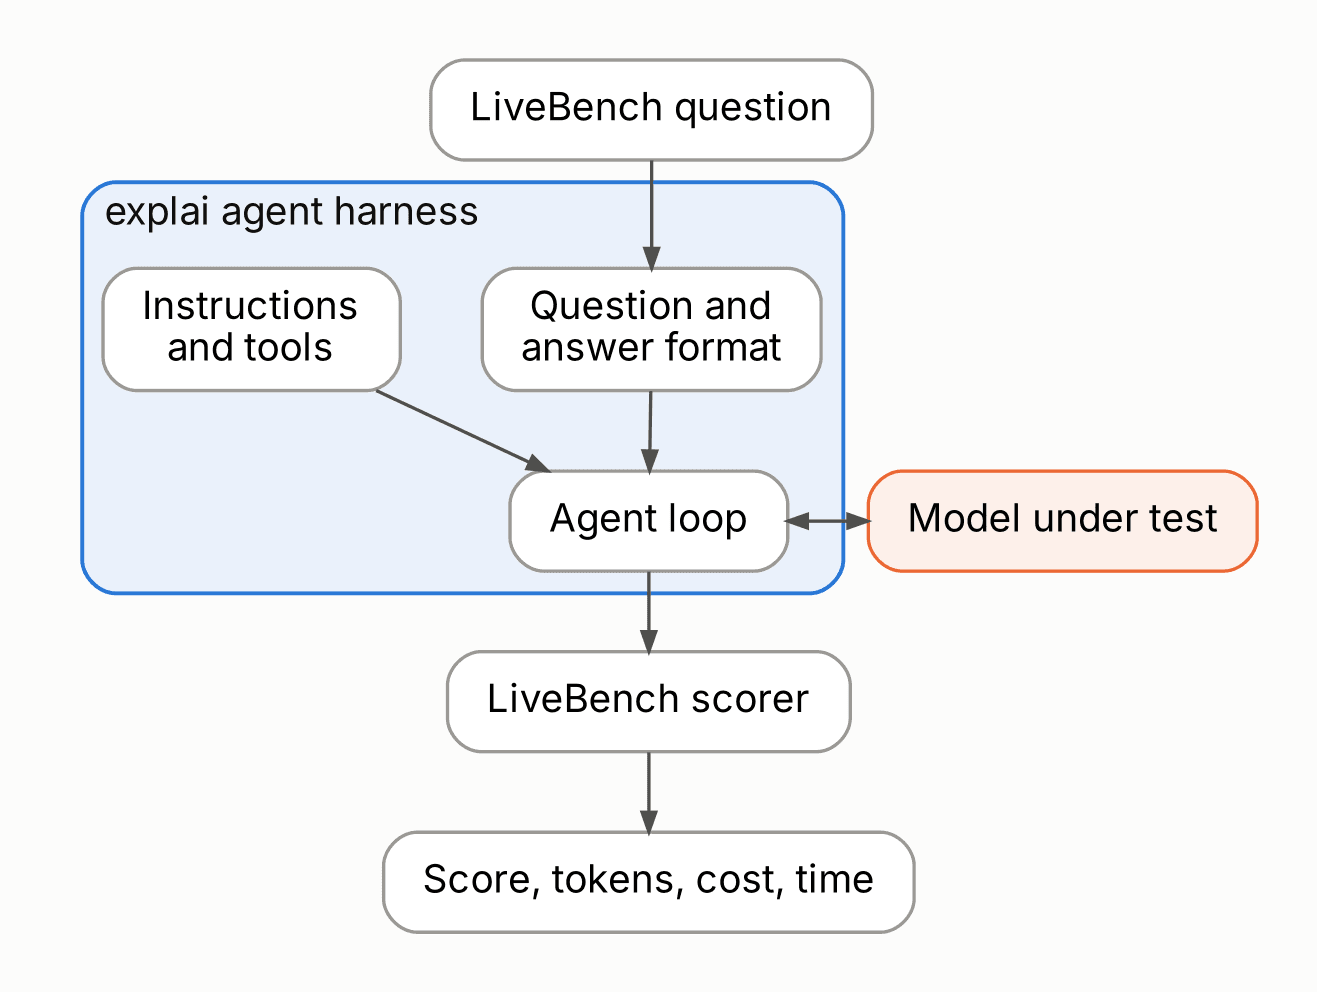
Ein Agent-Harness ist die Software, die aus einem Sprachmodell einen Agenten macht: Sie gibt dem Modell Anweisungen und Werkzeuge (Tools) an die Hand, führt die Tools aus, die das Modell aufruft, und spielt die Ergebnisse an das Modell zurück, bis die Aufgabe erledigt ist. Das explai Agent-Harness begleitet Data Scientists, Analysten und Fachabteilungen vom ersten Blick auf einen Datensatz bis zur Handlungsempfehlung. Diese Arbeit teilen sich mehrere spezialisierte Agenten, von denen jeder auf einem eigenen Modell laufen kann. Deshalb müssen wir wissen, welche Schritte ein günstigeres Modell übernehmen kann. An derselben Frage hängt, was eine Desktop-Version von explai lokal leisten könnte — eine Richtung, die wir in Density is all you need skizziert haben.
Öffentliche Ranglisten beantworten diese Frage nicht, denn sie testen das Modell für sich allein. In unserem Produkt steckt es dagegen im explai Agent-Harness, und das verändert Genauigkeit wie Kosten. Also haben wir die Modelle dort gemessen, wo sie auch arbeiten: im Harness.
2. Methodik
2.1 Benchmark
LiveBench ist der erste von inzwischen neun Benchmarks, mit denen wir Modelle im explai Agent-Harness getestet haben. Wir beginnen mit ihm, weil er grundlegende Fähigkeiten prüft.
LiveBench (White et al., 2024) bewertet Antworten per Code gegen bekannte Lösungen, ohne ein Sprachmodell als Richter. Dieselbe Antwort bekommt deshalb immer dieselbe Bewertung. Von den sieben Kategorien haben wir Data Analysis gewählt, weil sie unserem Produkt am nächsten kommt. Sie umfasst 150 Fragen, verteilt auf drei Aufgaben zu je 50:
- Spaltentyp-Annotation: eine Spalte anhand einiger ihrer Werte benennen; bewertet wird nur richtig oder falsch.
- Tabellen-Join: angeben, welche Spalten zweier Tabellen zusammengehören; bewertet mit dem F1-Maß, eine teilweise richtige Antwort bekommt also Teilpunkte.
- Tabellen-Umformatierung: eine Tabelle in ein anderes Format umwandeln, etwa von JSON nach CSV; dabei muss jede Zelle stimmen.
Der Score eines Modells ist der Anteil der erreichbaren Punkte, den es erzielt hat. Wir haben das Release 2024-06-24 verwendet, das jüngste mit öffentlichen Data-Analysis-Fragen.
2.2 Modelle
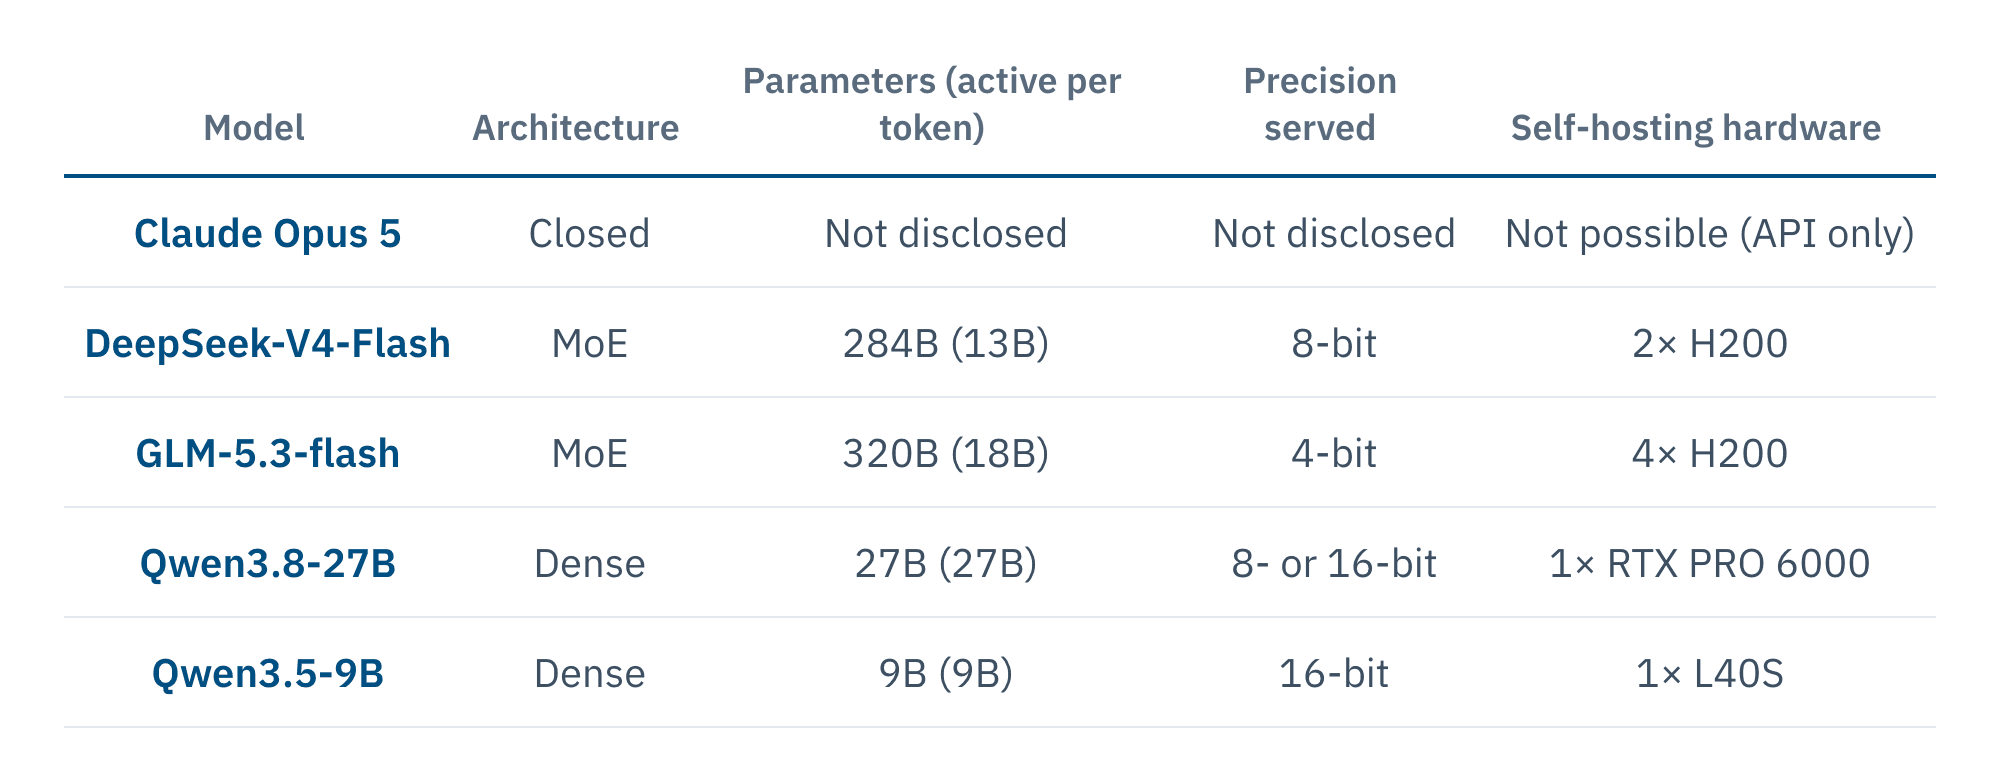
Wir haben Claude Opus 5 mit vier Open-Weight-Modellen verglichen (Tabelle 1). Zwei davon sind Mixture-of-Experts-Modelle (MoE): Sie aktivieren pro Token nur einen Teil ihrer Parameter (Shazeer et al., 2017). Das macht sie im Betrieb günstig, im Speicher liegen müssen trotzdem alle Gewichte.
2.3 Das explai Agent-Harness
Jede Frage lief durch dasselbe Harness, nur das Modell wechselte (Abbildung 1). Das Harness schickt dem Modell zuerst seine Anweisungen und die Beschreibungen von rund 67 Tools, zusammen 28.000 bis 42.000 Tokens pro Aufruf, dann die Frage und eine Zeile, die das Antwortformat festlegt. Wir haben die Prompts für kein Modell optimiert, die Websuche abgeschaltet und bei Opus 5 auf Extended Thinking verzichtet. Die offenen Modelle denken von sich aus nach, bevor sie antworten.
2.4 Statistik und Kosten
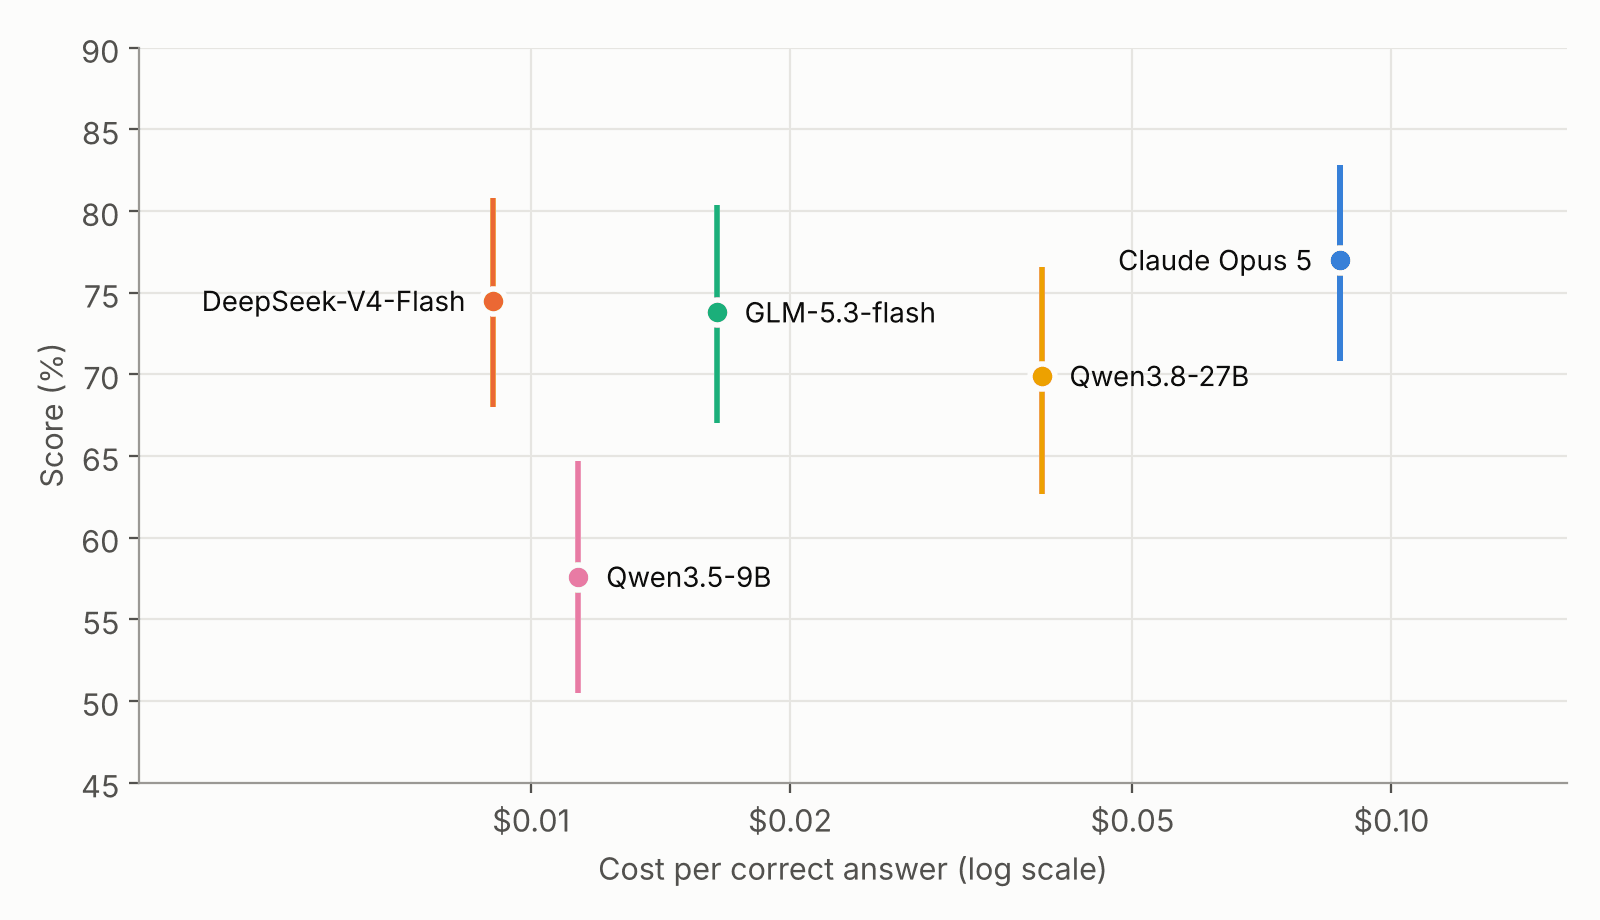
Zu jedem Score gehört ein 95-%-Intervall: der Bereich, in dem der Score sehr wahrscheinlich läge, wenn wir viele weitere Fragen derselben Art stellen könnten. 77,0 % (70,8–82,8 %) heißt also, dass der wahre Score des Modells höchstwahrscheinlich zwischen 70,8 % und 82,8 % liegt. Weil alle Modelle dieselben Fragen beantwortet haben, vergleichen wir jedes Modell zusätzlich Frage für Frage mit Opus 5 (Miller, 2024). Schließt das Intervall dieser Differenz die Null ein, lassen sich die beiden Modelle aus den Daten nicht unterscheiden.
Als Kostenmaß berichten wir die Kosten pro richtiger Antwort: die Kosten eines Durchlaufs zu den Preisen der Anbieter, geteilt durch die erzielten Punkte.
2.5 Reproduzierbarkeit
Das Harness verwendet ein fest vorgegebenes Benchmark-Release und führt den Bewertungscode von LiveBench unverändert aus. Es protokolliert Tokens und Kosten jedes Aufrufs und bricht ab, statt stillschweigend auf ein anderes Modell auszuweichen. Jedes Modell hat alle 150 Fragen einmal mit denselben Einstellungen beantwortet; leere Antworten zählen als falsch. Die Ergebnisse pro Frage geben wir auf Anfrage heraus.
3. Ergebnisse
3.1 Genauigkeit und Kosten
DeepSeek-V4-Flash lag 2,5 Prozentpunkte hinter Opus 5 (95-%-Intervall: 7,5 Punkte dahinter bis 2,6 davor), GLM-5.3-flash 3,2 Punkte (9,1 dahinter bis 2,9 davor). Beide Intervalle schließen die Null ein, der Abstand kann also Zufall sein: Auf diesen 150 Fragen lässt sich nicht sagen, dass Opus 5 besser ist als eines der beiden. Qwen3.8-27B (69,9 %) und Qwen3.5-9B (57,6 %) liegen messbar darunter.
Bei den Kosten kehrt sich die Reihenfolge um (Abbildung 2). Eine richtige Antwort kostete bei DeepSeek-V4-Flash ein Zehntel und bei GLM-5.3-flash ein Fünftel dessen, was sie bei Opus 5 kostete. Qwen3.5-9B hat zwar den niedrigsten Preis pro Token, sammelt aber so wenige Punkte, dass jede seiner richtigen Antworten teurer ist als eine von DeepSeek-V4-Flash.
3.2 Ergebnisse nach Aufgabe
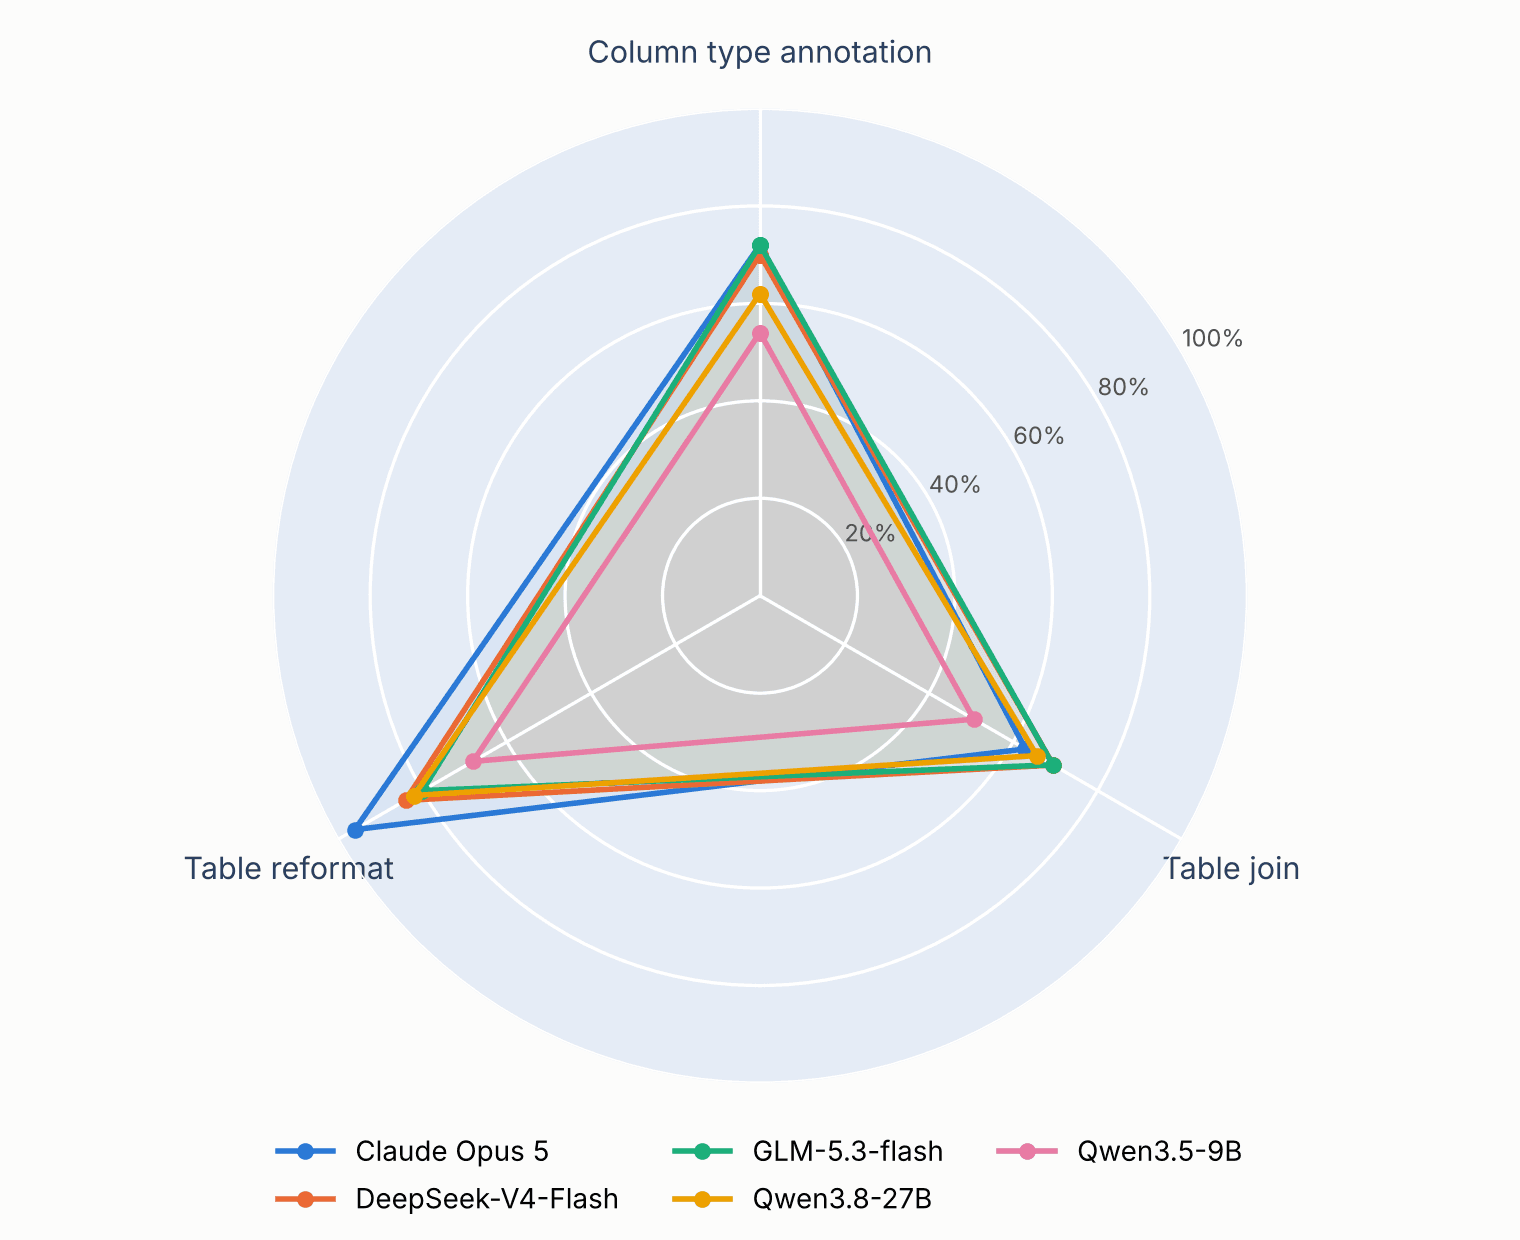
Am deutlichsten gehen die Modelle bei der Tabellen-Umformatierung auseinander (Abbildung 3). Opus 5 wandelte 48 von 50 Tabellen exakt um, die offenen Modelle 34 bis 42. Beim Tabellen-Join lagen DeepSeek-V4-Flash und GLM-5.3-flash rund 7 Punkte vor Opus 5, bei der Spaltentyp-Annotation gleichauf. Bei nur 50 Fragen je Aufgabe bleiben Abstände unter etwa 10 Punkten allerdings innerhalb der Fehlermarge.
3.3 Kosten des Eigenbetriebs
Wer DeepSeek-V4-Flash oder GLM-5.3-flash selbst betreiben will, braucht zwei bis vier H200-GPUs und damit geschätzt 3.300 bis 6.100 $ im Monat. Nutzt man dagegen ein bestehendes Modell per API, fallen mit einem auf Caching optimierten System wie explai nach unserer Erfahrung weniger als 100 € je Nutzer und Monat an. Die dichten Modelle kommen mit einer einzelnen Karte für etwa 800 bis 1.000 $ im Monat aus, und die 27 Milliarden Parameter von Qwen3.8-27B passen mit 8 Bit sogar in den Speicher eines starken Laptops — beide schnitten jedoch schlechter ab (Abbildung 4).
3.4 Tokens, Zeit und Ausfälle
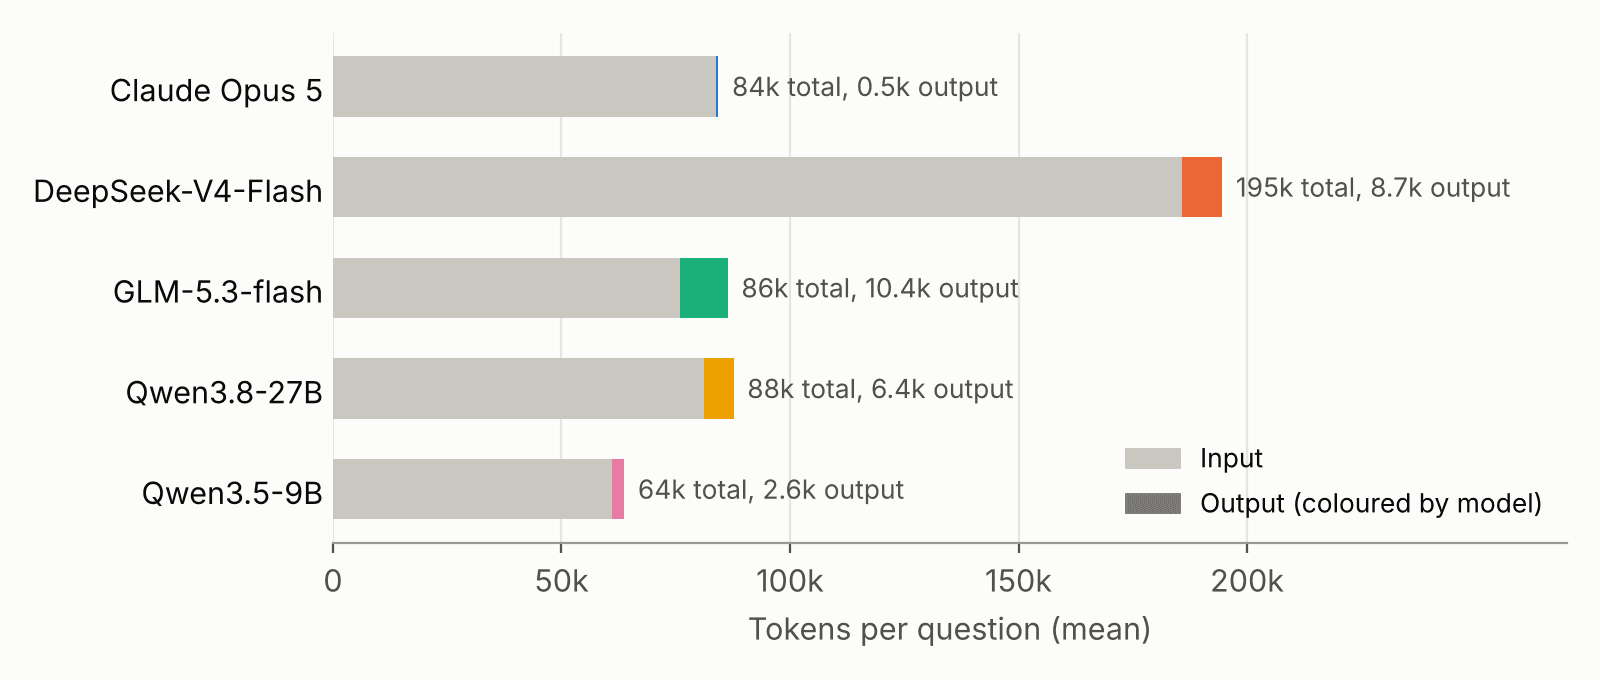
Die meisten Tokens entfallen auf die Anweisungen des Harness selbst (Abbildung 5). Opus 5 schrieb pro Frage rund 460 Output-Tokens, die offenen Modelle mit ihrem vorgeschalteten Nachdenken 2.600 bis 10.400. Prompt Caching (Dokumentation von Amazon Bedrock) drückte die Kosten von Opus 5 von rund 0,43 $ auf 0,067 $ pro Frage.
Eine typische Frage dauerte bei jedem Modell etwa eine Minute, im Median 58 bis 72 Sekunden. Die langsamste Antwort von Opus 5 brauchte rund zwei Minuten; bei jedem offenen Modell gab es dagegen Antworten, die 15 bis 35 Minuten liefen, und die jeweils langsamste Antwort war bei allen Modellen falsch. 15 der 750 Antworten kamen leer zurück, keine davon von Opus 5; zehn davon, darunter alle sieben von GLM-5.3-flash, überschritten in beiden Versuchen das Antwortlimit.
3.5 Stichprobengröße
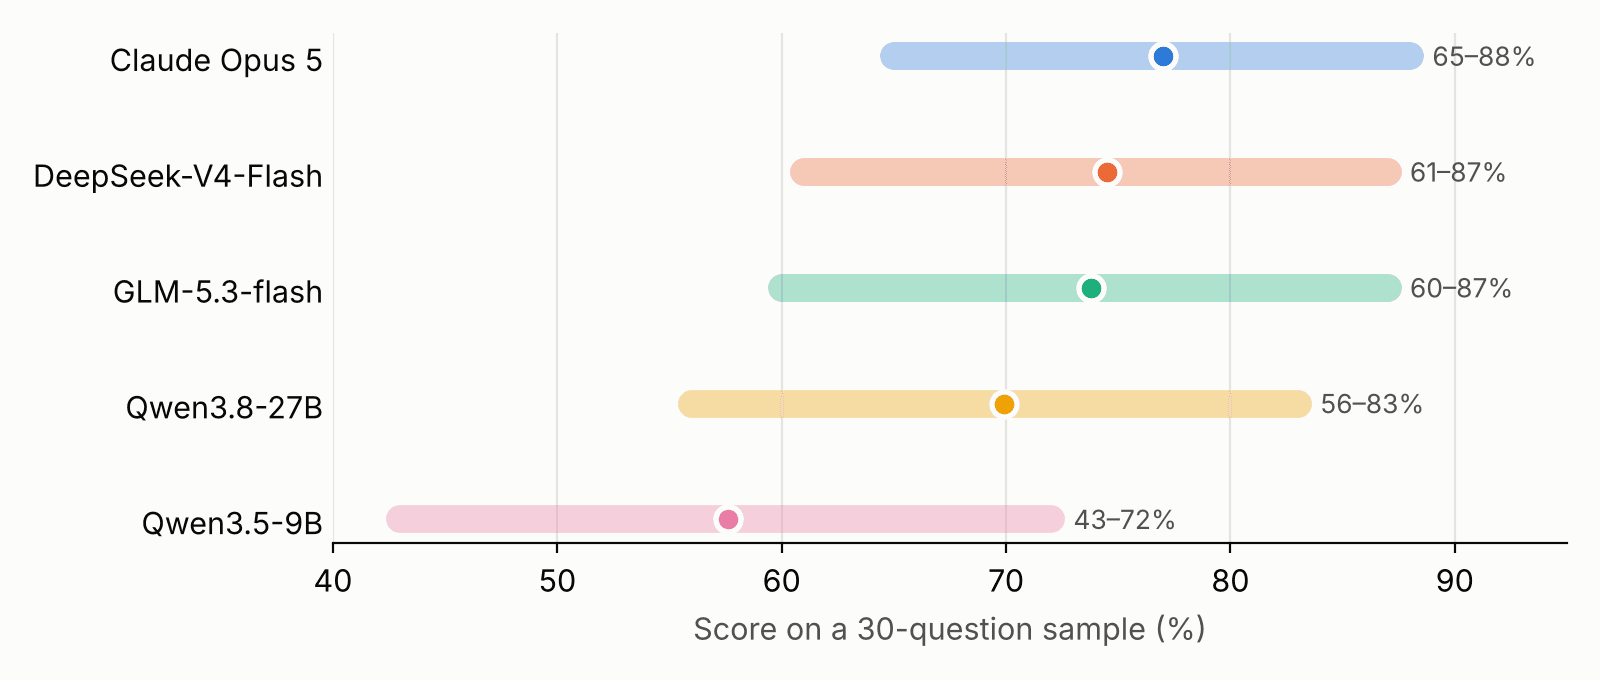
Aus den 150 Fragen haben wir 10.000 zufällige Sätze zu je 30 Fragen gezogen und alle fünf Modelle mit ihren bereits vorliegenden Antworten auf denselben Sätzen bewertet. So klein gewählt, überlappen sich die Scores der vier besten Modelle fast vollständig (Abbildung 6), und bei rund einem Drittel der Sätze schnitt DeepSeek-V4-Flash besser ab als Opus 5.
4. Diskussion
4.1 Günstig pro Antwort, aber zu groß für eine GPU
Die beiden MoE-Modelle, die mit Opus 5 mithielten, bringen insgesamt 284 bzw. 320 Milliarden Parameter mit, nutzen pro Token aber nur 13 bzw. 18 Milliarden davon. Über die API sind sie deshalb günstig; im Eigenbetrieb verlangen sie leistungsfähige Hardware, denn allein die Gewichte von GLM-5.3-flash belegen selbst mit 4 Bit rund 160 GB. Die dichten Modelle, die auf eine Karte passen, blieben zurück. Fünf Modelle reichen nicht, um die Effekte von Größe, Architektur und Trainingsdaten auseinanderzuhalten; für den lokalen Einsatz ist die Folgerung trotzdem klar: Bei diesen Aufgaben erreichen Modelle, die auf einfacher Hardware laufen, das Frontier-Niveau noch nicht.
4.2 Das Harness brauchte seine Tools kaum
Jede LiveBench-Frage bringt ihre Daten selbst mit, die meisten Antworten kamen deshalb ohne Tools aus. Opus 5 und Qwen3.5-9B riefen überhaupt keines auf. Die anderen drei Modelle griffen bei 11 bis 24 schweren Fragen zu Tools und schnitten dort nicht besser ab als Opus 5 ohne sie. Der Test misst also eher, wie sich die Modelle unter unseren Anweisungen schlagen, als wie gut unsere Tools sind.
4.3 Manche Fragen sind nicht beantwortbar
An neun Fragen zum Spaltentyp scheiterten alle fünf Modelle, und mindestens zwei davon lassen sich aus den gegebenen Daten gar nicht beantworten. Eine zeigt fünf Preise zwischen 41 und 58 und fragt, ob sie aus der Spalte Open, High, Low oder Close stammen. Alle Modelle antworteten Close, laut Lösung ist es Low. Solche Fragen drücken alle Scores gleichermaßen, der Vergleich bleibt also gültig — belohnt wird dort aber glückliches Raten statt Analyse.
4.4 Dreißig Fragen reichen nicht
Mit 30 Fragen hätten wir die vier besten Modelle nicht in eine Reihenfolge bringen können. Deshalb führen wir jeden Benchmark inzwischen vollständig aus und geben zu jedem Score ein Intervall an.
5. Was das für explai bedeutet
Spaltentypisierung und Tabellenabgleich kommen dafür infrage, an ein offenes MoE-Modell weitergereicht zu werden, mit Opus 5 als Rückfallebene. Exakte Transformationen bleiben beim stärkeren Modell oder bekommen eine deterministische Prüfung, etwa einen Vergleich der Zeilen- und Spaltenzahl von Input und Output. Reasoning-Modelle brauchen ein größeres Output-Budget und ein Zeitlimit, denn ihre langsamsten Antworten waren falsch. Und der Umfang der Anweisungen treibt die Kosten: In der Cloud fängt Caching das ab, auf einem Laptop dagegen werden die Zehntausenden Anweisungs-Tokens, die vor dem ersten Wort einer Antwort zu verarbeiten sind, zur größten Verzögerung einer Desktop-Version.
6. Grenzen und nächste Schritte
Diese Studie umfasst einen Benchmark mit drei tabellenbezogenen Aufgaben, einen Durchlauf je Modell und Opus 5 ohne Extended Thinking. In den nächsten Beiträgen berichten wir von vollständigen Durchläufen der übrigen acht Benchmarks zu SQL, Function Calling, mehrstufiger Tool-Nutzung, Diagrammen, Statistik und Data-Science-Code; dort vergleichen wir die Modelle allein mit denselben Modellen im explai Agent-Harness. Außerdem testen wir Opus 5 mit Extended Thinking, wiederholen Durchläufe, um die Streuung zu messen, und messen auf dem Gerät selbst, sobald die Desktop-Version Gestalt annimmt. LiveBench hält seine neuesten Fragen unter Verschluss, unsere Scores sind deshalb nicht mit der aktuellen Rangliste vergleichbar; untereinander bleiben sie vergleichbar, weil alle fünf Modelle dieselben Fragen beantwortet haben.
Testen Sie den explai Agent mit Ihren eigenen Daten in der explai Sandbox.